Technische Optimierung und Zugang für KI-Crawler
Stand: 4. Oktober 2026
KI-Anbieter können Ihre Inhalte nur nutzen, wenn sie an Ihre Website herankommen. Die Seite Technische Optimierung im Bereich Optimierung prüft genau das, für die gesamte Website und nicht für einzelne Seiten. Wie gut die Inhalte einzelner Seiten lesbar sind, zeigt die Seite Inhaltliche Optimierung. Sie ist hier beschrieben: Inhaltliche Optimierung und Lesbarkeits-Index.
Warum falsche Crawler-Einstellungen unsichtbar machen können und wie Sie sie prüfen, beschreibt das Praxis-Handbuch in Kapitel 16, KI-Crawler-Steuerung.
Wofür die Seite da ist
Drei Dinge entscheiden, ob KI-Crawler an Ihre Inhalte kommen: ob die Datei robots.txt sie hereinlässt, ob Ihr Server sie durchlässt und ob eine Sitemap ihnen alle Seiten zeigt. Die Seite prüft alle drei und fasst den Stand zusammen. Sie ist eine Voraussetzung für Sichtbarkeit in KI-Antworten. Ein offener Zugang belegt noch nicht, dass eine KI Ihre Inhalte versteht oder Ihre Marke nennt.
Was Sie sehen
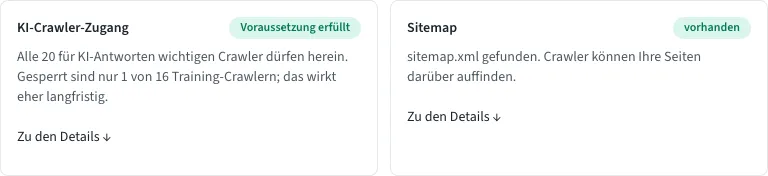
Oben stehen zwei Kacheln, KI-Crawler-Zugang und Sitemap, jeweils mit einem Kurzurteil. Darunter folgen die Abschnitte im Detail:
- KI-Crawler-Zugang (robots.txt): Die robots.txt ist eine Absichtserklärung des Website-Betreibers. Die Seite sortiert die bekannten KI-Crawler in Gruppen. Zu den für KI-Antworten wichtigen Crawlern, die Ihre Inhalte holen, um Fragen jetzt zu beantworten, kommt eine zweite Gruppe für Training und Daten mit eher langfristiger Wirkung. Eine dritte Gruppe sammelt Crawler, die die Seite nicht eingeordnet hat und deshalb nicht bewertet.
- Nutzungssignale in der robots.txt: die Zeile Content-Signal in der robots.txt, mit der eine Website erklärt, wofür Anbieter ihre Inhalte verwenden dürfen. Das ist eine Bitte an die Anbieter und sperrt technisch nichts.
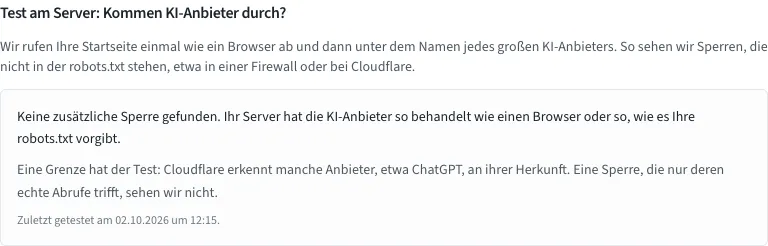
- Test am Server: Kommen KI-Anbieter durch?: der Abruf Ihrer Startseite, einmal wie von einem Browser und dann unter dem Namen jedes großen KI-Anbieters. So fallen Sperren auf, die nicht in der robots.txt stehen, etwa in einer Firewall oder bei Cloudflare.
- Sitemap (sitemap.xml): ob eine sitemap.xml vorhanden ist, also eine Liste aller Seiten, damit Crawler nichts übersehen.
Am Ende zeigt die Seite die Messmethode samt Grenzen und einen Hinweis auf die Seite Inhaltliche Optimierung. Beim ersten Besuch öffnet sich außerdem eine kurze Erklärung der Seite. Mit Verstanden schließen Sie sie; neben der Überschrift bleibt sie über das Info-Zeichen erreichbar.
Den Befund lesen
Die Kachel zum Crawler-Zugang nennt, wie viele der für KI-Antworten wichtigen Crawler gesperrt sind und welche. Sind alle erlaubt, steht dort, dass die Voraussetzung erfüllt ist. Gesperrte Training-Crawler sind ein eigener Fall: Sie nehmen Ihnen keinen Platz in aktuellen KI-Antworten, können aber langfristig beeinflussen, ob ein Modell Ihre Marke kennt. Das betrifft besonders kleinere Marken. Gesperrte Bereiche wie Login oder Warenkorb sind meist unbedenklich. Enthält ein gesperrter Bereich Inhalte, die zitiert werden sollen, lohnt ein Blick in die robots.txt.
Beim Test am Server gibt es mehrere mögliche Ergebnisse. Der wichtigste: Ihr Server sperrt einzelne KI-Anbieter gezielt. Dann nennt die App diese Anbieter in einem eigenen Kasten, denn deren Assistenten können Ihre Seiten nicht abrufen. Liefen nur einzelne Abrufe nicht sauber durch, etwa wegen einer Drosselung, meldet die App, dass sie keine Sperre bestätigen konnte. Findet der Test keine zusätzliche Sperre, hat Ihr Server die KI-Anbieter so behandelt wie einen Browser oder so, wie es die robots.txt vorgibt. Weist er automatisierte Abrufe allgemein ab, sind KI-Assistenten davon mitbetroffen, und Ihr Hoster oder Website-Betreuer weiß, ob das gewollt ist. Antwortet die Startseite schon einem Browser nicht normal, gibt es für die KI-Anbieter kein Ergebnis. Liefert der Test kein belastbares Ergebnis, prüfen Sie später erneut.
Was Sie hier tun können
Mit Erneut prüfen prüfen Sie die Website erneut, etwa nachdem Ihre Agentur die robots.txt geändert hat. Robots.txt und Sitemap werden dabei sofort neu gelesen, und zwischen zwei Prüfungen muss mindestens eine Minute liegen. Der Test am Server startet im Hintergrund, dauert bis zu drei Minuten und läuft höchstens alle zehn Minuten; die Seite aktualisiert sich dann von selbst. Liegt die letzte Runde noch keine zehn Minuten zurück, prüft die Seite nur robots.txt und Sitemap neu und sagt das auch. Neben dem Knopf steht, wann zuletzt geprüft wurde.
Wurde die Website noch nie geprüft, bietet die Seite stattdessen Website jetzt prüfen an. Crawler-Zugang und Sitemap erscheinen danach nach wenigen Sekunden, das Ergebnis des Tests am Server nach wenigen Minuten.
Bei einer Sperre zeigt die Seite unter den empfohlenen Schritten, welche Einträge Sie in der robots.txt suchen und wie sie aussehen sollten. Die Datei liegt im Hauptverzeichnis Ihrer Website, und Ihre Agentur oder Ihr Website-Betreuer ändert sie in der Regel schnell. Fehlt die Sitemap, lassen Sie eine erzeugen; die meisten Redaktionssysteme können das automatisch.
Im Musterkunden bleibt die Prüfung gesperrt. Dort erscheint der Hinweis Im Musterkunden nicht verfügbar. Hier sehen Sie Beispieldaten.
Wer das darf
Ansehen darf die Seite jedes Mitglied des Arbeitsbereichs. Eine neue Prüfung auszulösen verlangt das Recht, Inhalte zu ändern und Messungen zu starten. Das haben die Rollen Admin und Ändern. Mit der Rolle Nur lesen können Sie die Seite lesen, aber keine Prüfung anstoßen.
Wenn etwas nicht stimmt
- Die Seite meldet, die robots.txt konnte nicht gelesen werden: Dann lässt sich der Crawler-Status gerade nicht bestimmen, und der Test am Server startet meist nicht. Prüfen Sie, ob die Datei unter Ihrer Domain erreichbar ist, und prüfen Sie dann erneut.
- Nach Erneut prüfen erscheint die Meldung, die letzte Prüfung liege weniger als eine Minute zurück. Warten Sie kurz und versuchen Sie es noch einmal.
- Die Prüfung schlägt fehl: Die Seite bittet darum, es erneut zu versuchen. Tun Sie das nach einem Moment.
- Die Zeile Content-Signal in Ihrer robots.txt verbietet KI-Antworten oder die Aufnahme in Suchindizes, obwohl Sie das nicht wollten: Schreibt ein Plugin oder Cloudflare die Zeile automatisch, ändern Sie die Einstellung dort.